原文链接:https://dev.to/gramli/to-retry-or-not-to-retry-that-is-the-question-1j2l
作者:Daniel Balcarek(@gramli),后端架构与性能方向的资深软件工程师 译注:以下为文章正文的中文翻译,已略去页面中的广告与评论区内容。
Kaggle 基准挑战(Benchmarking Challenge)参赛作品 —— 本文是提交给 Kaggle Benchmarking Challenge 的作品。
读过我文章的人都知道,我的很多文章其实是某种基准测试(benchmark)。大部分和 .NET 相关,所以有人可能会说,这次挑战赛应该跟我平时做的事情挺接近的。
事实恰恰相反。
构建一个代码基准测试,和对 AI 模型做基准测试,是两个完全不同的世界。所以我刚看到这个挑战赛时,完全不知道该测什么。让模型在编码任务上互相比较显得太泛泛了,我也不想为了做基准而做一个基准。
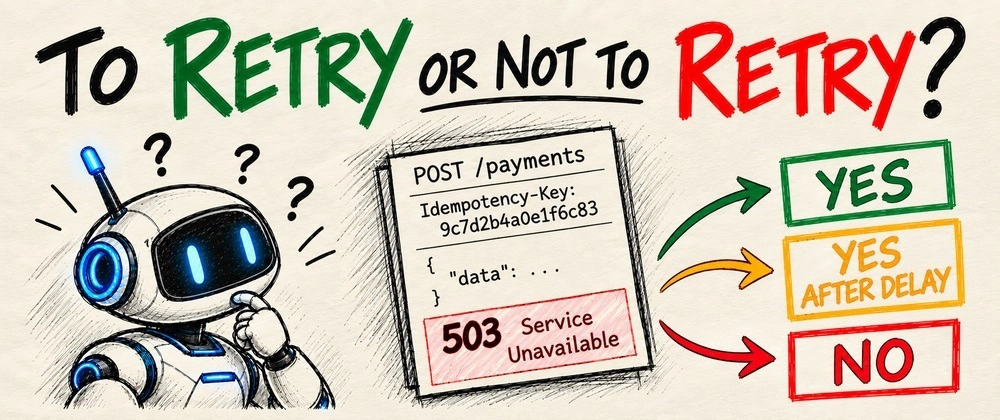
然后我回头看了一下最近几篇文章的主题。其中很多关于 API、弹性(resilience)、故障,以及系统在出问题时的行为。这让我想到了一个实验点子:如果我让 AI 模型回答一个非常简单的问题来做基准测试,怎么样?要不要重试?(To Retry or Not to Retry?)
一个 503 Service Unavailable 并不自动意味着重试是安全的。一个 POST 请求可能已经被处理过了。一个幂等键(idempotency key)可以彻底改变答案。超时可能发生在服务器收到任何东西之前,也可能发生在它已经修改了某些状态之后。
所以单凭 HTTP 状态码往往是不够的,模型必须理解整个情境。
我测试了什么(What I Benchmarked)
思路很简单。我准备了若干个 API 故障场景,每个场景包含请求、响应以及一些额外上下文的信息。模型需要返回两样东西:
-
一个决策:
YES、NO或YES_AFTER_DELAY -
一句解释原因的话
例如:
POST /payments
503 Service Unavailable

An idempotency key was supplied and the API guarantees
duplicate requests with the same key are not processed twice.

Retry?
开发者大概率会立刻回答:
YES_AFTER_DELAY
关键不只是那个 503。上下文告诉我们提供了幂等键,用同一个 key 重复请求不会把付款处理两次。但 AI 模型能注意到同样的细节吗?更重要的是,当场景不那么显而易见时,会发生什么?
为了这个小实验,我准备了那些答案取决于 HTTP 方法、状态码、幂等性、限流(rate limiting)等细节的场景。
每个模型都收到相同的响应格式:
Decision: YES | NO | YES_AFTER_DELAY
Reason: <one sentence>
打分时我只使用 Decision(决策)。这让基准测试保持简单且确定。Reason(理由)不影响得分。我收集它是因为它能展示模型究竟是真正理解了场景,还是碰巧以错误的原因给出了正确答案。这也让各模型之间的比较变得简单:每个场景都有一个预期决策,最终结果可以直接算成模型答对的重试决策百分比。
但为什么要对这种东西做基准测试呢?
想象一下,你正在对接一个外部服务,希望让这个调用更有弹性。在当今 AI 辅助编码的世界里,很有可能是由一个编码 Agent 来干这活。AI 可以轻松生成一套重试策略。更有意思的问题是:它会重试正确的请求吗? 因为重试了不该重试的东西,可能比完全不重试还要糟糕得多。
这就是我想要衡量的。现在我们来看看这些场景。
场景(Scenarios)
我准备了 14 个场景,每个都基于 Kaggle 基准中实际使用的任务。最初它们全部打算写进文章里,但那是个小实验,这样文章就太长了。所以我决定把完整场景放到一个独立应用里,在那里你可以浏览每个任务及其预期答案和解释。如果你想自己先试试,还有一个专供人类的测试。毕竟,为什么不顺便给人类也做个基准呢?
试试人类基准或浏览全部场景:To Retry or Not to Retry?
以下是实验中使用到的场景:
-
安全的付款重试(Safe Payment Retry) —— 付款请求因
503 Service Unavailable失败,但幂等键保证重试不会创建重复付款。 -
不安全的付款重试(Unsafe Payment Retry) —— 付款请求返回
503 Service Unavailable并带有Retry-After,但没有幂等键,所以重试可能造成重复扣款。 -
幂等的 PUT(Idempotent PUT) ——
PUT请求发送成功,但响应到达之前连接断开。 -
被限流的订单(Rate-Limited Order) —— 订单请求在处理之前被限流,返回带
Retry-After的429 Too Many Requests。 -
付款详情冲突(Payment Details Conflict) —— 多步骤付款流程走到
/payments/details,返回409 Conflict且transient-error: false。 -
非幂等的 PATCH(Non-Idempotent PATCH) ——
PATCH请求用于增加库存,但在客户端得知更改是否已应用之前连接就断了。 -
幂等的 DELETE(Idempotent DELETE) —— 删除会话的请求已发出,但响应到达之前连接断开。
-
服务不可用(Service Unavailable) ——
GET请求收到503 Service Unavailable,并带有Retry-After头。 -
资源版本过期(Stale Resource Version) —— 资源被另一个客户端更新过,因此使用旧 ETag 的
PATCH失败,返回412 Precondition Failed。 -
没有 Retry-After 的限流(Rate Limit Without Retry-After) —— 一个安全的
GET请求反复收到429 Too Many Requests,但服务器没有提供Retry-After头。 -
我是个茶壶(I'm a Teapot) —— 咖啡请求收到了传奇的
418 I'm a Teapot响应。 -
最终一致性(Eventual Consistency) —— 新创建的资源在另一个服务尝试使用时立刻返回
404 Not Found。 -
过期的过滤工作流(Expired Filter Workflow) —— 一个临时过滤器多次超时,最终返回
404 Not Found,原过滤器再也无法使用。 -
缓存的购物车选项(Cached Cart Options) —— 获取购物车选项的请求因
504 Gateway Timeout失败,但一份刚刚过期的缓存响应仍可通过stale-if-error使用。
被测模型(Models Tested)
挑选模型的过程相当直接。首先,我选了工作中常用的模型:GPT-5.6 Luna 和 GPT-5.6 Sol。以我的经验,Luna 非常高效——它比 Sol 犯错更多,但消耗的 token 也明显更少。
然后我加入了 Gemini 3.7 Flash 和 Gemini 3.1 Pro Preview。这两个我都经常用于文本生成和 CSS 样式。
我还纳入了 Claude Sonnet 5 和 Claude Haiku 4.5。我以前大量使用 Claude 写代码,但最近基本转到了 GPT-5.6,因为它对我的工作流来说更高效。
最后,出于好奇,我加了 GLM-5 和 DeepSeek-R1,想看看它们的表现如何。
我也尝试加入 Grok,但 Grok 4.5 和 Grok 4.6 都立刻报了 404 Not Found 错误,所以它们没有出现在结果里。
目标不是测遍所有可用的模型,而是把我已经在用的一批模型和我好奇的几个放在一起比较。
发现(Findings)
好,先看看第一次运行的排行榜和结果。
可以看到,得分 1.00 的最佳模型是 GPT-5.6 Sol,其次是只错一次的 Gemini 3.7 Flash。然后是四个各错两次的模型,DeepSeek-R1 错了三次,Claude Haiku 4.5 以错五次垫底。
细看之下,大部分模型都在 不安全的付款重试(Unsafe Payment Retry) 任务上犯了错。这个任务本身有迷惑性,因为有 Retry-After 头,但重复那个请求可能造成重复扣款。只有 GPT-5.6 Sol 和 Gemini 3.1 Pro Preview 答对了。其余模型返回的内容类似:
Decision: YES_AFTER_DELAY
Reason: The server explicitly requests waiting 10 seconds before attempting the request again.
(服务器明确要求等待 10 秒后再尝试该请求。)
所以大多数模型掉进了"跟随明显的 HTTP 信号"的陷阱,尽管这个信号与更大的上下文相冲突。Retry-After 说"重试",但一笔没有幂等保障的付款说"最好别"。说实话,我很高兴大部分模型都失败了。这对作者来说是个小小的胜利——我偶尔还能骗过 AI。
让我惊讶的还有,一些模型在幂等 HTTP 方法的任务上翻了车:幂等的 PUT 和 幂等的 DELETE。但它们并没有完全答错,大多数回答的是 YES_AFTER_DELAY,因为它们假设这是暂时的网络问题,延迟之后就能解决。
这些 YES 与 YES_AFTER_DELAY 的案例说明,模型可能理解重试是安全的,但在什么时候重试上与你有分歧。这和误解场景是两回事。所以在 v2 版本里,我可以对某些场景允许多个有效的 Decision 值。也就是说,在这些案例里,其实是 AI 给我上了一课。
三次运行,不止一次(Three Runs, Not Just One)
那只是第一次运行,但我不想让整个实验建立在单次运行之上,所以我把同一个基准又跑了两遍,以检验模型的稳定性并收集更多数据。
| 模型 | 第 1 次 | 第 2 次 | 第 3 次 | 平均 |
|---|---|---|---|---|
| GPT-5.6 Sol | 14/14 | 14/14 | 13/14 | 13.67 |
| Gemini 3.7 Flash | 13/14 | 13/14 | 13/14 | 13.00 |
| Gemini 3.1 Pro Preview | 12/14 | 12/14 | 13/14 | 12.33 |
| GLM-5 | 12/14 | 13/14 | 12/14 | 12.33 |
| Claude Sonnet 5 | 12/14 | 12/14 | 12/14 | 12.00 |
| GPT-5.6 Luna | 12/14 | 12/14 | 12/14 | 12.00 |
| DeepSeek-R1 | 11/14 | 10/14 | 10/14 | 10.33 |
| Claude Haiku 4.5 | 9/14 | 9/14 | 9/14 | 9.00 |
总体来看,结果其实相当稳定。在 112 个"模型-场景"组合(8 个模型 × 14 个场景)中,有 102 个在三次运行中对错结果完全一致,约为 91%。但有意思的是,相同的得分并不总意味着相同的行为。有些模型答对的数量很稳定,但答错的场景却在变。三次都拿 12/14,不一定意味着模型每次都做出了相同的决策。
这在**过期的过滤工作流(Expired Filter Workflow)*上尤其明显:有四个模型的结果在运行之间发生了变化——GPT-5.6 Sol、Gemini 3.1 Pro Preview、GLM-5 和 DeepSeek-R1。连前两次拿到 14/14 的 GPT-5.6 Sol,也在第三次把答案从 YES 改成了 YES_AFTER_DELAY。它仍然判定该请求应该重试,只是对何时*重试产生了分歧。这正是让我质疑"精确区分 YES 与 YES_AFTER_DELAY 的打分是否总是正确做法"的那类场景。
额外的运行也让不安全的付款重试这一发现更有分量。24 次作答中它只被答对了 6 次,仅 25%。更有意思的是,这个结果在各次运行之间完全一致:GPT-5.6 Sol 和 Gemini 3.1 Pro Preview 三次全对,而其余六个模型每一次都错。所以这更像是模型理解该场景时的一种系统性陷阱,而不是随机的模型波动。
另一方面,14 个场景中有 7 个在全部 24 次作答中都被答对。因此那些直截了当的重试案例,并不是拉开模型差距的地方。差异出现在重试时机、更大上下文或多步骤状态开始重要的时候。
模型效率(Model Efficiency)
现在看看效率。我用第三次运行的图表,因为在三次运行中,各模型在图上大致都落在相同的区域。
To Retry or Not to Retry?:得分 vs. 总成本帕累托图
GPT-5.6 Luna 看起来是效率最高的模型,我一点也不意外。我在工作中主要用它,因为它便宜,而且通常能把我带到接近最终方案的附近。
Claude Haiku 4.5 也处在"高效"一角,但它在所有被测模型中成绩最差,而且仍然比 GPT-5.6 Luna 更贵。
其余模型都在右上角,让我真正吃惊的是 DeepSeek-R1 居然成了第二贵的模型。于是我去看了它的输出,发现 DeepSeek-R1 每次回答长度从 4,000 到 9,000 字符不等,尽管它本该只回答 Decision 和 Reason。其他所有模型都遵守了这条指令,所以在这个案例里,成本差异不仅来自 token 定价,还来自模型对要求输出格式的遵守程度。
我学到了什么(What I Learned)
设计这个实验时,我其实担心这些场景对当今的 AI 模型来说会太简单。结果表明事实并非总是如此。是的,我肯定可以改进这个基准,尤其是 YES 与 YES_AFTER_DELAY 之间的歧义问题。但即便是最强的模型,一旦决策不再只取决于明显的 HTTP 信号,它们仍然会犯错。真实系统里的重试决策并不总是简单的。AI 确实能帮我们推理困难案例,但更大的上下文依然重要,盲目听从模型的答案是有风险的。
我的基准(My Benchmark)
To Retry or Not to Retry? Benchmark(Kaggle)
Kaggle 对我来说完全是新领域,说实话,我很高兴是通过 DEV.to 挑战赛发现了它。我本以为配置过程会复杂得多,但直接在 UI 里创建这个小实验基准出乎意料地简单。我肯定会继续探索 Kaggle,尤其是在看到传统 ML 竞赛之外还有这么多可挖掘的东西之后。